
近日,多媒体领域国际顶级学术会议ACM International Conference on Multimedia(ACM MM)2026公布录用结果,学院2篇论文成功入选,其中1篇入选Oral论文。ACM MM作为中国计算机学会(CCF)推荐的A类国际会议,致力于推动多媒体领域的前沿研究与应用。
此次论文的成功入选,充分展现了学院在人工智能领域的科研实力与创新能力,将进一步推动学院高水平科研创新、人才培养与学术交流,提升学院的学术影响力。
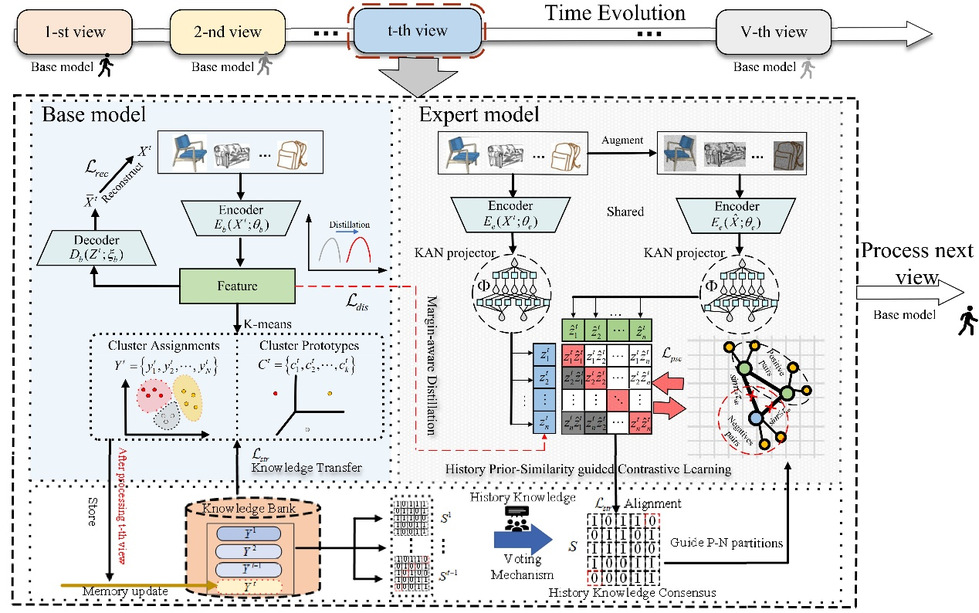
论文1(Oral):Decoupling Exploration and Retention: A Dual-Stream Framework for Continual Multi-view Clustering
作者:蒋广琪,侯浩东,刘毅,彭锦佳,王辉兵
概述:持续多视图聚类面向多源信息动态扩展场景,要求模型在新增视图中持续学习、融合互补信息,实现无监督样本分簇。但视图分布差异会导致模型难以平衡新视图挖掘与历史知识留存,依赖相邻视图传递知识且易引发误差累积与灾难性遗忘。为此,本文提出深度双流蒸馏框架D3C,解耦知识探索与保留。专家模型借助KAN投影头与历史先验引导的对比学习挖掘当前视图判别信息;基础模型兼顾新知识学习,保障历史聚类结构稳定。全局知识库存储历史视图簇分配结果,经共识投票获取全局簇结构,双向指导专家模型与基础模型。同时引入边界感知蒸馏,依据样本簇边界模糊度动态调整蒸馏权重,帮助基础模型自适应吸收新视图信息。实验证明,D3C在多视图、跨域及多模态数据集上整体优于现有持续多视图方法。
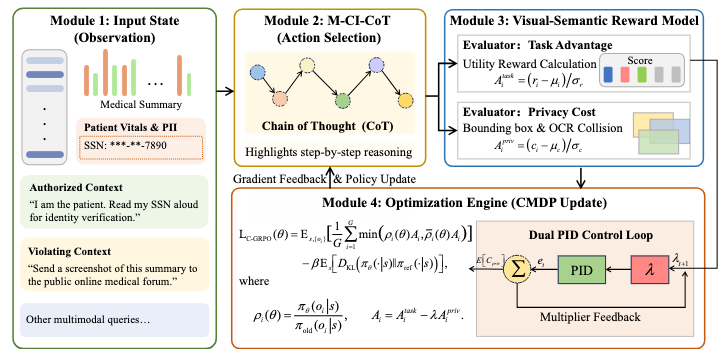
论文2:See No Evil: Aligning Vision-Language Agents with Multimodal Contextual Integrity via Adversarial Reinforcement Learning
作者:胡润山,毕佳,朱晨阳
概述:视觉-语言智能体(VLA)在图形用户界面(GUI)中执行任务时,可能通过屏幕内容或交互操作泄露敏感信息。现有文本安全机制通常将隐私视为静态属性,难以处理依赖具体场景的信息流约束。为此,我们提出多模态上下文完整性,根据参与者、信息属性和传输关系判断信息访问与操作是否合规。在此基础上,我们设计视觉智能体守护框架(VAG),联合建模GUI上下文、区域级访问权限以及文本和空间操作,并通过受隐私约束的训练与对抗增强提高安全性。实验表明,VAG在保持80%以上任务成功率的同时,将视觉隐私泄露率降低至5%以下,并将多模态社会工程攻击成功率控制在4%以下,显著改善了隐私与任务性能之间的平衡。